コンテンツにスキップ
SeedAudio

SEED AUDIO 1.0 PROMPT GUIDE

場面を書きます。
サウンドを形作ります。

この Seed Audio 1.0 プロンプト ガイドを使用して、ダイアログ、音楽、雰囲気、音響効果を計画してください。テンプレートから開始し、音声リファレンスをマッピングし、再生可能なサンプルを通じて各命令の動作を学びます。

THE LAST TRAIN10s · IT / ZH
01 シーン

夜行列車。窓の外は雨。

02 声

Lia ↔ Marco · 自然な順番取り

03 タイムライン
0.2s · Lia3.0s · Marco5.6s · Lia8.4s · Marco
04 レイヤー

クリアな音声 + ソフトホイールと雨 · 音楽なし

オリジナルのプロンプトの概要

テキストは必須です

テキストだけでも機能します。 プロンプト は 2,048 文字以内にしてください。

参照はオプションです

必要に応じて、1 つの画像または最大 3 つのオーディオ クリップを追加します。組み合わせないでください。

音声を順番にマップする

オーディオ参照の場合は、アップロード順に @Audio1、@Audio2、@Audio3 を使用します。

THE SHORT VERSION

再生順に書き込みます。

最初に何が起こるか、リスナーが何に注目すべきか、シーンがどのように終わるかを説明します。シーンに必要な音声とサウンド レイヤーのみを保持します。

01 / TEMPLATES

明確な概要から始めましょう。

1 つのテンプレートをコピーし、括弧を置き換えます。未使用の音楽、話者、エフェクトを削除し、セリフを引用符で囲みます。画像や音声の参照を追加する場合でも、説明を書面で残してください。

T2A · テキスト、オプションの画像

[言語]で[ターゲットの長さ][音声フォーマットまたはシーン]を作成します。
シーン: [場所、アクション、雰囲気]。
声: [話者、声質、感情、ペース]。
「[正確な会話またはナレーション]」とのみ言ってください。
オープニング: [最初に聞こえるイベント]。
次に、[再生順序での会話とアクション]。
アンビエンス: [連続的な背景音、距離、強度]。
音楽: [スタイル、楽器、強さ、始まりと終わり。未使用の場合は削除します]。
効果音: [キー操作が順番に鳴ります。未使用の場合は削除します]。
エンディング: [最後の出来事と自然な衰退]。
スピーチが先行する場合は、雰囲気や音楽をその下に置いてください。
[不要な音声、音楽、エフェクト] は省略します。
TA2A · テキスト + 音声リファレンス

[話者 A] の音声リファレンスとして @Audio1 を使用します。
@Audio2 を [話者 B、必要に応じて] の音声参照として使用します。
[言語]で[ターゲットの長さ]のシーンを作成します。
シーン: [場所、アクション、雰囲気]。
話者 A ([感情、ペース、休止]): 「[正確なライン]」。
話者 B ([必要に応じて配送]): "[正確な返信]"。
アンビエンス: [連続的な背景音、距離、強度]。
音楽: [スタイル、楽器、強さ、始まりと終わり。未使用の場合は削除します]。
効果音:[オープニング、アクション、エンディングの順]。
アンビエンスと音楽をダイアログの下に保ち、各 話者 を同じリファレンスにマッピングします。
未使用の 話者 および参照線を削除します。引用されたセリフのみを話します。

02 / PROMPT FORMULA

書く前に 4 つの決断をしましょう。

シーン

形式、場所、アクション、言語、雰囲気、ターゲットの長さを設定します。

声

話者 に名前を付け、正確なセリフを入力し、声の質、感情、ペースを説明します。

タイムライン

オープニングから始めてセリフやアクションを配置し、最後にエンディングを描きます。

レイヤー

アンビエンス、音楽、キーエフェクトを分離します。何が導き、何がその背後に残るのかを述べてください。

03 / INPUT MODES

音を導くものを選択してください。

サウンドシーンを作成するときは、テキストから始めます。参照する音声の方向がすでにある場合は、音声を追加します。どちらのパスでも、シーンとサウンド イベントの書面による説明が必要です。

書面による準備書面

夜行列車。雨を背に、二つの声が交代する。

オプション: 1 つのシーン画像
入力計画図

T2A

テキスト、オプションの画像付き

説明に基づいてモデルにサウンドをデザインしてもらいたい場合は、T2A を選択してください。テキストだけで十分です。 1 つの画像がシーンを確立するのに役立ちます。画像を使用する場合は、音声参照を追加しないでください。

画像に基づいた書き方の例

アップロードした夜行列車の画像をシーンの参考として使用してください。自然な英語を話す 2 人の乗客の後ろでハンドルを維持し、雨を降らせてください。リアは「もうすぐそこですか?」と尋ねます。マルコは「次の停留所」と答えます。短い列車の終点で終わり、音楽はありません。

記述例:画像、話者、行を自分のものに置き換えます。この例では音声は生成されていません。

声を役割にマッピングする
Nora@Audio1
Ethan@Audio2
入力計画図

TA2A

音声参照付きのテキスト

ターゲットの音声がある場合や、話者 ごとに一貫した音声が必要な場合は、TA2A を選択してください。すべてのクリップを役割にマッピングし、セリフ、感情、ターンテイクをテキストで説明します。

リファレンスクリップの選択

ターゲットの音声がクリアで、背景の干渉が少ないクリップを優先してください。アップロード順に、Nora を @Audio1 に、Ethan を @Audio2 にマッピングし、それぞれに行を割り当てます。

リファレンスを聞いて、役割のマッピングを確認してください。 プロンプト における感情とペースの変化について説明します。

それぞれ 30 秒以内、10 MB 以内のリファレンス クリップを準備します。あなたが所有する、または使用許可を得ている素材を使用してください。

04 / VOICE CHECKLIST

各 話者 に方向を与えます。

VOICE DIRECTIONキャラクターを聞いてください。
続いて声の説明をします。
ボーカルの質感情ペース

役割

誰が話しているのか、そのシーンとどのように関係しているのか?

ボーカルの質

暖かい、明るい、呼吸がしやすい、静かなどの便利な特性を選択します。

言語

シーンに必要な言語とアクセントに名前を付けます。

感情

1 つの制御されたキューから始めて、耳を傾けます。

ペース

自然な順番の切り替え、一時停止、強調を説明します。

パフォーマンス

息を入れたり、笑ったり、ささやいたりするのは、それが必要な場所だけにしてください。

指示を 1 つの文にまとめる

温かみのある少し低い声の大人のナレーターが、穏やかな話し方、文章間の簡単な休止、重要なフレーズの軽度の強調を伴い、適度なペースで自然な英語を話します。

05 / LAYER TIMELINE

あらゆるサウンドをシーンに配置します。

「The First Sip」を使用して順序を確認します。缶が開き、氷とシュワシュワが製品を確立し、音声が到着し、音楽が解決されます。以下の時間はオリジナルの プロンプト から取得したものであり、編集点が保証されたものではなく、目標値です。

THE FIRST SIP最初の一口00:00 — 00:12
0~2秒

オープニング

缶を開けて氷を入れて注ぐ。

2~8秒

スピーチ

短くて明確な製品ライン。

1~12秒

その下の音楽

明るいグルーヴが声の下に残ります。

12秒までに

エンディング

泡と音楽は一緒に解決します。

サウンド プランニング図 · 結果は 1 つの混合オーディオ トラックになります。

06 / ORIGINAL EXAMPLES

オリジナルの プロンプト から学びましょう。

3 つのシーンを聞いて、プロンプト がダイアログ、製品サウンド、音声リファレンスをどのように配置するかを確認してください。それぞれには、オーディオ、提出された完全な プロンプト、および独自のシーンに適応できる主要な説明が含まれています。

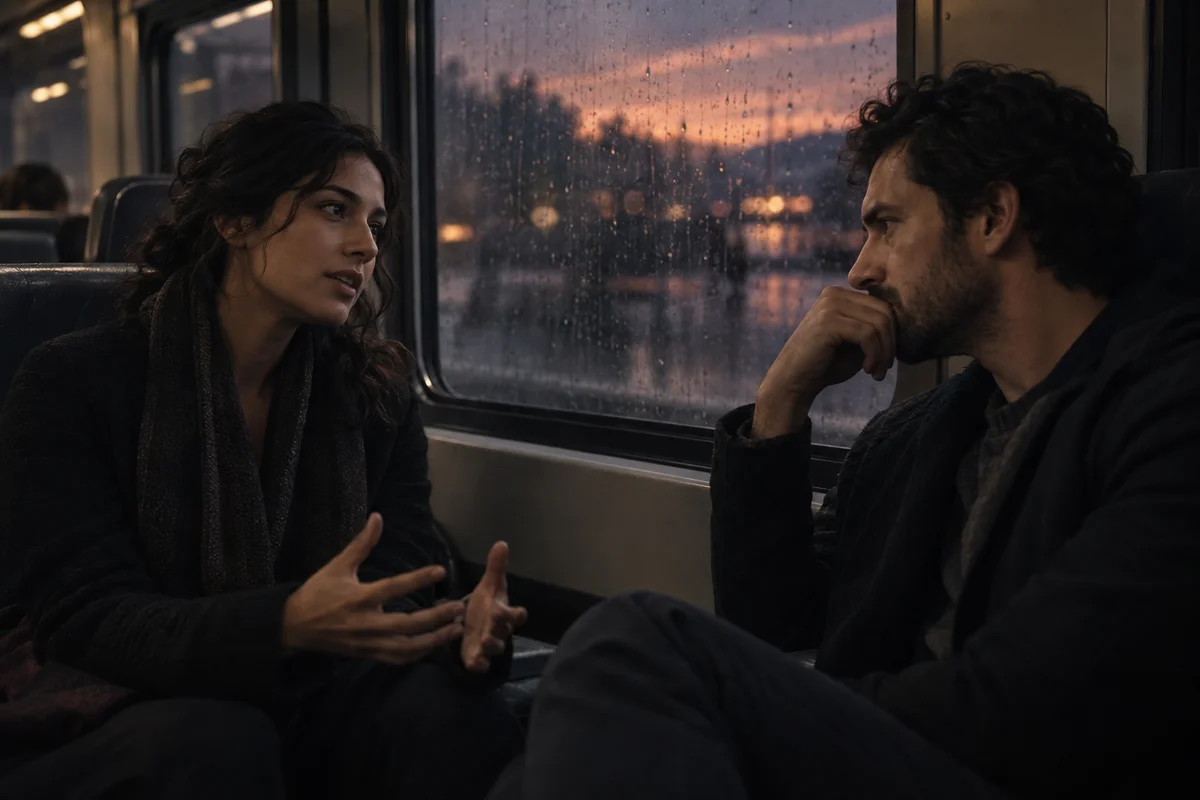
電車内で雨のしみがついた窓の横で会話する 2 人の旅行者

01 / T2A

最終列車

何を聞くべきか
イタリア語版と中国語版を比較してください。自然な方向転換と、声の背後にある車輪と雨の位置に耳を傾けてください。

最終列車 · イタリア語

主要な指示の仕組み

柔らかく途切れることのないホイールと、近くにあるクリアな声の背後にある雨。
リスニングの優先順位を設定します。スピーチを前面に出しながら、雨をカフェの雰囲気に置き換えます。

劇的な休止や長引く言葉はありません
ペースとターンテイクを指示します。現場で必要な場合は、これをより穏やかな、またはよりためらった表現に置き換えてください。

引用されたセリフのみを話します。
話された言葉とシーンの指示を分離します。引用符内のダイアログを置き換えます。

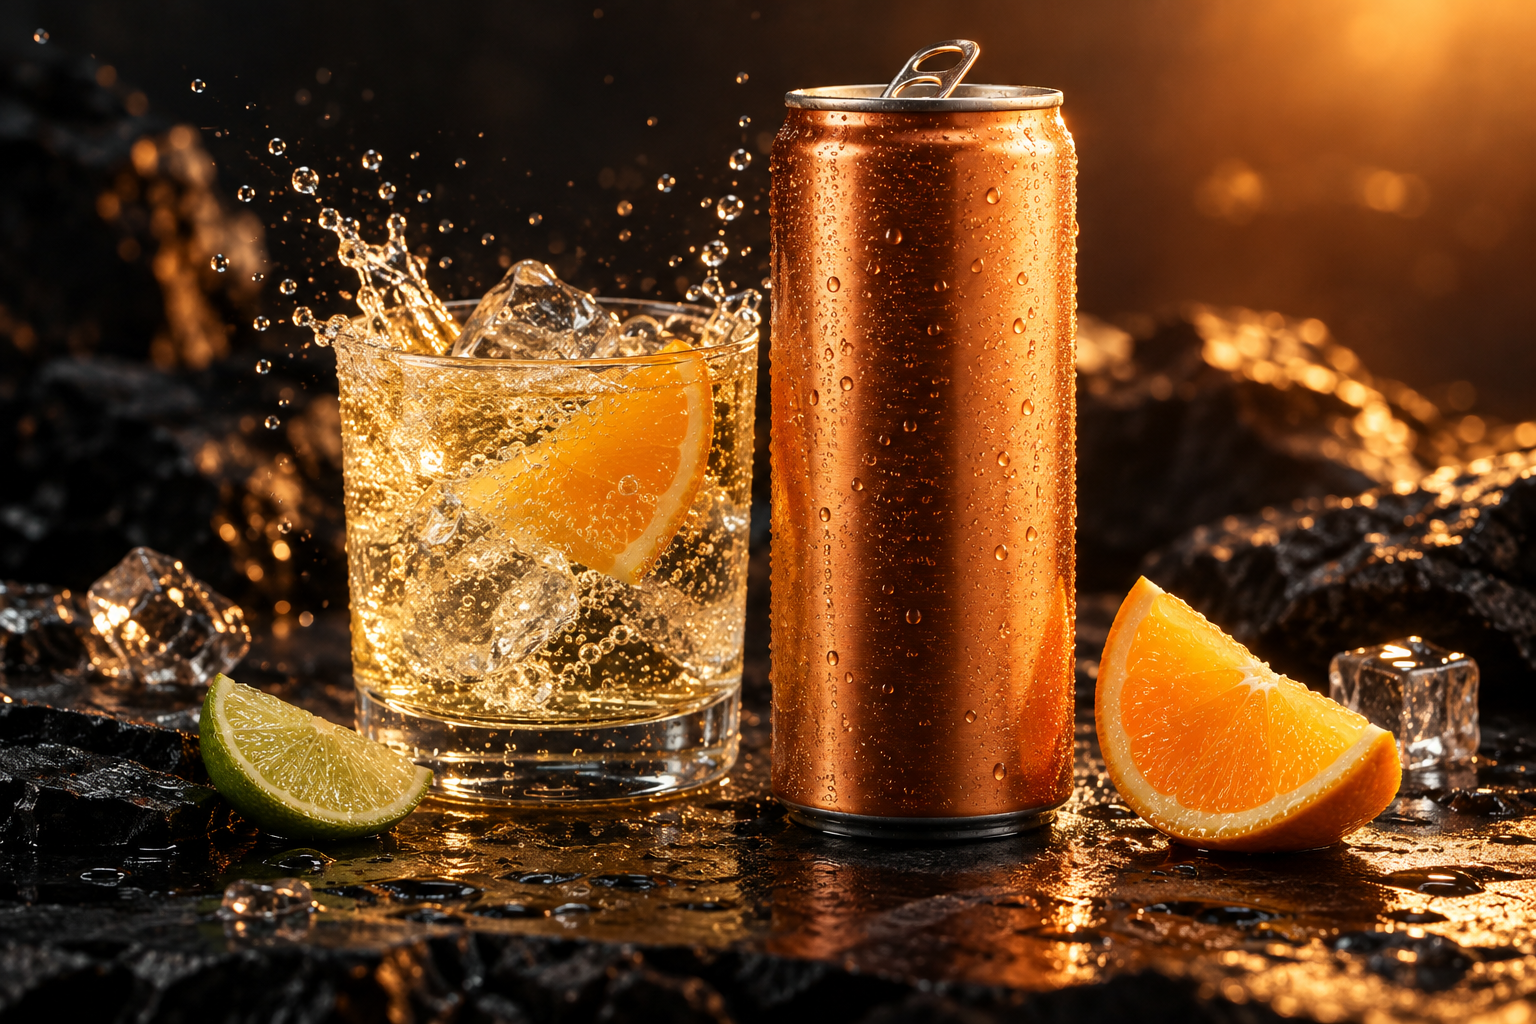
暗いスタジオで、ノーブランドの冷たい柑橘類の飲み物を氷、炭酸水、水しぶきの横に置くことができます。

02 / T2A

最初の一口

何を聞くべきか
缶を開ける音と氷の音、声が届くタイミング、そして泡と音楽がどのように終わるかを聞いてください。

最初の一口

主要な指示の仕組み

さわやかなアルミニウムのプルタブスナップ
独特の開始音に名前を付けます。パッケージ化、ボタンの押下、または別のキー操作に置き換えてください。

声の下に留まる
ナレーションの後ろに音楽を配置します。スピーチを前面に出したまま、音楽スタイルを変更します。

泡と音楽を一緒に解決しましょう
シーンがどのように終了するかを説明します。最終的なサウンドとそのエンディングを独自に置き換えます。

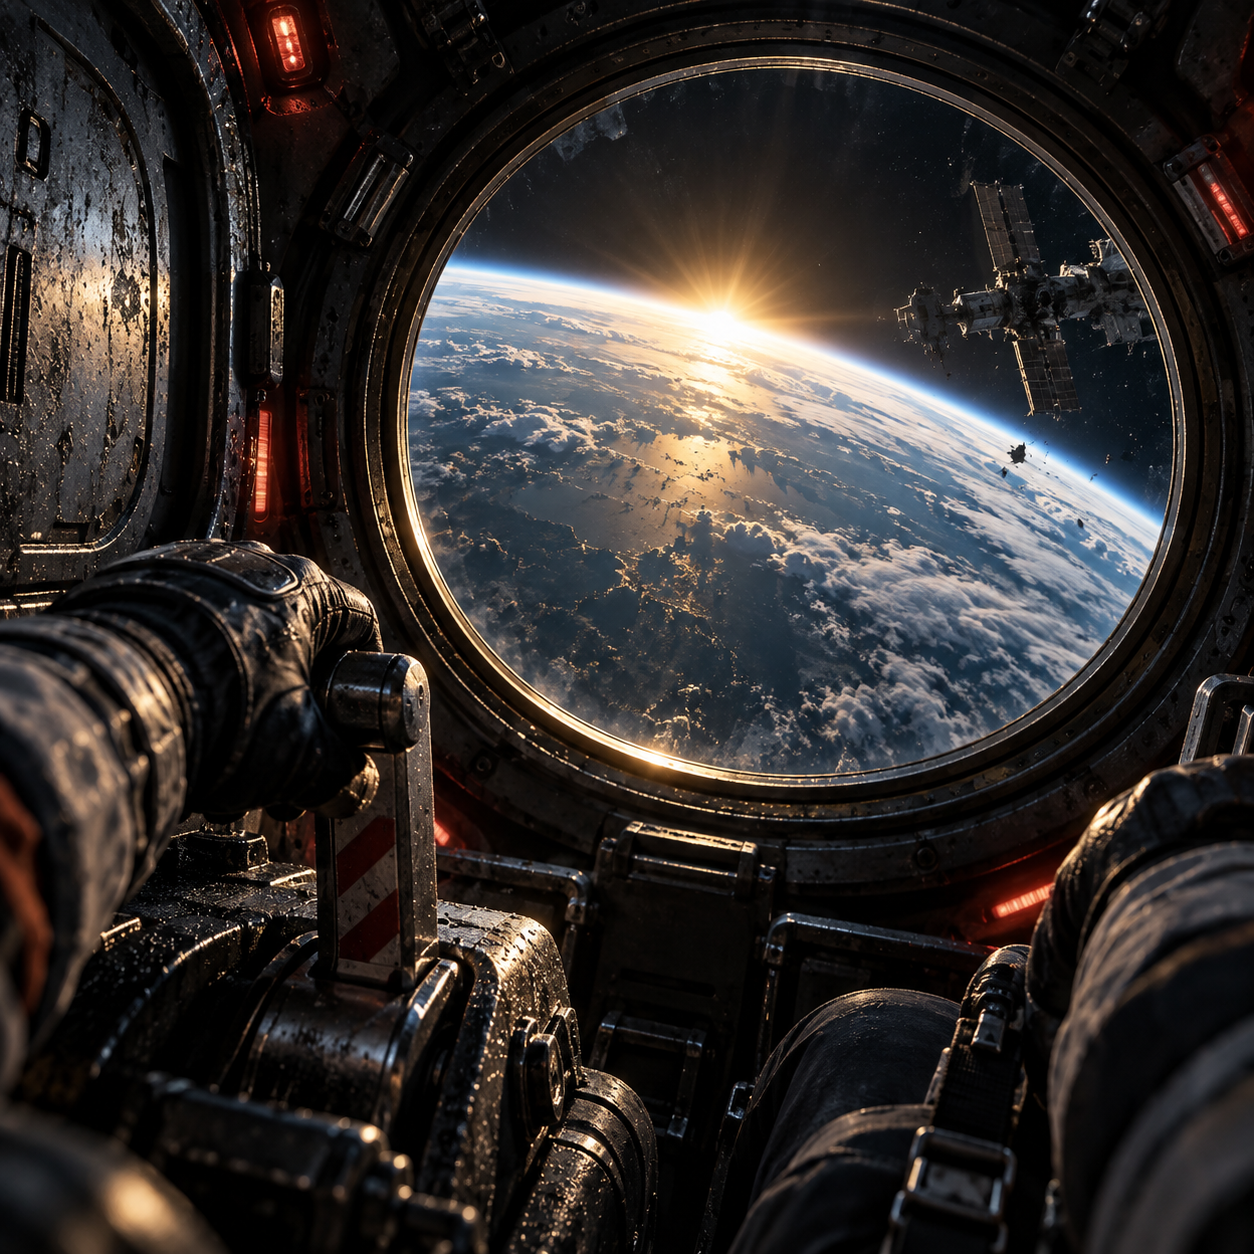
地球の日の出に面した宇宙カプセル内の緊急解除レバー

03 / TA2A

脱出まであと 16 秒

何を聞くべきか
まず Nora と Ethan の音声を聞いてから、生成されたシーンを比較します。音声マッピングとセリフの周囲のアクション音に従ってください。

@Audio1 · 入力基準

Nora

@Audio2 · 入力基準

Ethan

生成された音声

脱出まであと 16 秒

主要な指示の仕組み

@Audio1 の声
Nora を最初の参照にマップします。 Ethan は @Audio2 をフォローしています。アップロード順序の一貫性を維持しながら名前を変更します。

レバーがカチャカチャ鳴る。エンジンは立ち上がる力強い咆哮を伴います。
アクション音をシーケンスします。アクションを置き換えるときは、各音がダイアログのどこに属するかを伝えます。

アラームが止まります。揺れる船体を滑らかなエンジン音で置き換える
サウンドの変化を使用してシーンを解決します。背景音を入れ替えて、何が止まり、何が置き換えられるかを言います。

07 / COMMON MISTAKES

ミックスが混雑していると感じる場合は、簡素化します。

競合する層が多すぎる

アンビエンスベッドを 1 つと、シーンを支援する少数のイベントを維持します。

マップされていない参照

各 @Audio 参照の後にどの役割が続くかをモデルに伝えます。

キーワードの山

曖昧: 「雨、電車、映画的。」より明確に: 「車輪と雨から始めて、2 人の乗客が順番に話して、最後に短い車両のアンビエンス テールで終了します。」

矛盾する配信キュー

話者 ごとに、主要な感情を 1 つ選択し、明確なペースを選択します。

期間を正確に扱う

結果を聞いて、編集にトリミングの余地を残しておきます。

音声の指示ではなく名前

役割と声質について説明します。許可を得て音声リファレンスを使用してください。

NEXT SCENE

テンプレートを使用して次のシーンを開始します。

テンプレートをコピーし、シーンとダイアログを置き換えて、ジェネレーターに貼り付けます。聞いた後は、細部を 1 つずつ変更して、スピーチ、背景、結末を比較します。