Use este guia Seed Audio 1.0 prompt para planejar diálogos, música, ambiente e efeitos sonoros. Comece com um modelo, mapeie suas referências de voz e aprenda o que cada instrução faz por meio de exemplos jogáveis.
O texto sozinho funciona. Mantenha seu prompt com até 2.048 caracteres.
02
Referências são opcionais
Se necessário, adicione uma imagem ou até três clipes de áudio. Não os combine.
03
Mapeie vozes em ordem
Para referências de áudio, use @Audio1, @Audio2 e @Audio3 na ordem de upload.
THE SHORT VERSION
Escreva na ordem de reprodução.
Descreva o que acontece primeiro, no que o ouvinte deve focar e como a cena termina. Mantenha apenas as vozes e camadas sonoras que a cena precisa.
01 / TEMPLATES
Comece com um resumo claro.
Copie um modelo e substitua os colchetes. Remova músicas, falantes ou efeitos não utilizados e coloque as linhas faladas entre aspas. Mantenha uma descrição escrita mesmo ao adicionar uma imagem ou referência de áudio.
T2A · Texto, imagem opcional
Crie uma [duração alvo] [formato de áudio ou cena] em [idioma].
Cena: [lugar, ação e clima].
Voz: [falante, qualidades vocais, emoção e ritmo].
Diga apenas: "[diálogo ou narração exata]".
Abertura: [primeiro evento sonoro].
Depois: [diálogo e ações na ordem de reprodução].
Ambiente: [sons de fundo contínuos, distância e intensidade].
Música: [estilo, instrumentos, intensidade, entrada e finalização; remova se não for utilizado].
Efeitos sonoros: [a ação principal soa em ordem; remova se não for utilizado].
Final: [último evento e uma decadência natural].
Quando a fala lidera, mantenha o ambiente e a música abaixo dela.
Deixe de fora: [vozes, músicas ou efeitos indesejados].
TA2A · Referências de texto + áudio
Use @Audio1 como referência de voz para [falante A].
Use @Audio2 como referência de voz para [falante B, se necessário].
Crie uma cena de [duração desejada] em [idioma].
Cena: [lugar, ação e clima].
falante A ([emoção, ritmo e pausas]): "[linha exata]".
falante B ([entrega, se necessário]): "[resposta exata]".
Ambiente: [sons de fundo contínuos, distância e intensidade].
Música: [estilo, instrumentos, intensidade, entrada e finalização; remova se não for utilizado].
Efeitos sonoros: [abertura, ações e finalização em ordem].
Mantenha o ambiente e a música abaixo do diálogo e cada falante mapeado para a mesma referência.
Remova falantes e linhas de referência não utilizadas. Fale apenas as linhas citadas.
02 / PROMPT FORMULA
Quatro decisões antes de escrever.
01
Cena
Defina o formato, local, ação, idioma, humor e duração do alvo.
02
Voz
Nomeie o falante e as linhas exatas e, em seguida, descreva a qualidade vocal, a emoção e o ritmo.
03
Linha do tempo
Comece com a abertura, organize o diálogo e as ações e depois descreva o final.
04
Camadas
Ambiente, música e efeitos principais separados. Diga o que leva e o que fica por trás.
03 / INPUT MODES
Escolha o que guia o som.
Comece com texto ao inventar uma cena sonora. Adicione áudio quando você já tiver uma direção de voz para referência. Ambos os caminhos ainda necessitam de uma descrição escrita da cena e dos eventos sonoros.
Resumo escrito
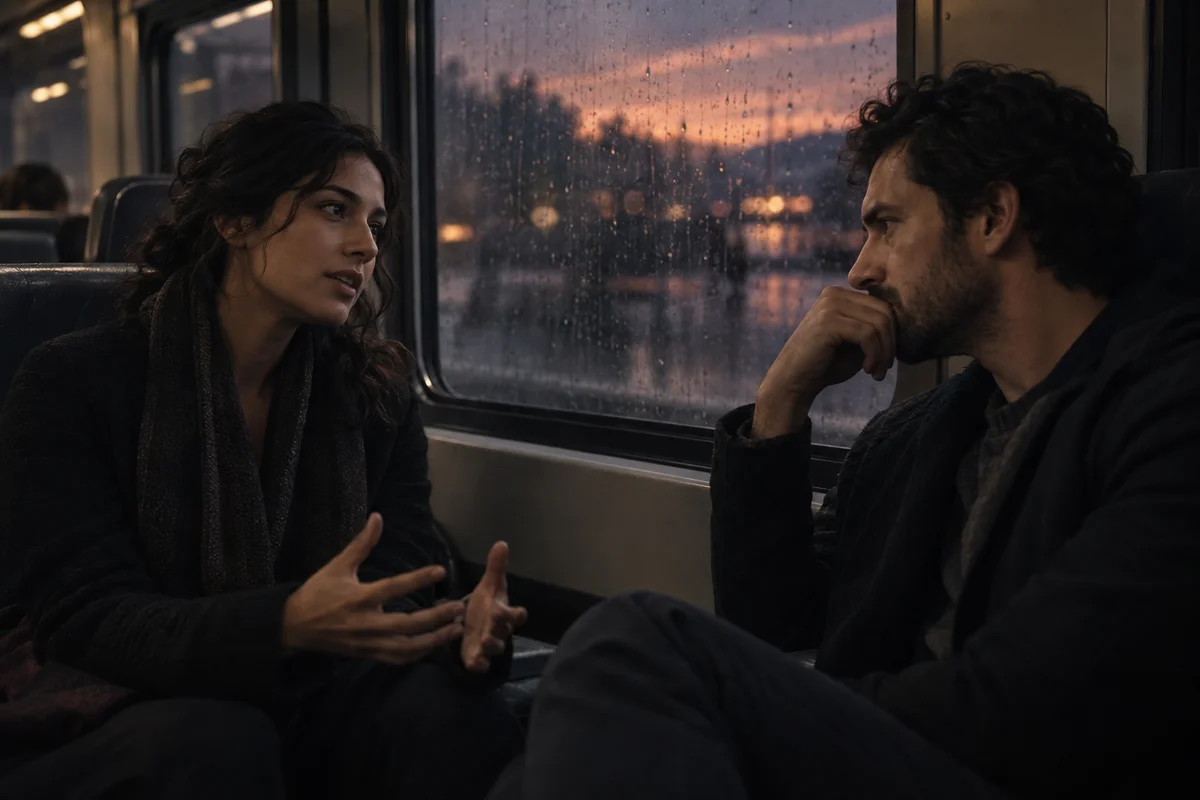
Um trem noturno. Duas vozes se revezam, com a chuva atrás delas.
Opcional: uma imagem de cena
Ilustração de planejamento de entrada
T2A
Texto, com imagem opcional
Escolha T2A quando quiser que o modelo projete o som a partir de sua descrição. Só o texto é suficiente; uma imagem pode ajudar a estabelecer a cena. Não adicione referências de áudio ao usar uma imagem.
Exemplo de escrita guiada por imagem
Use a imagem carregada do trem noturno como referência de cena. Mantenha as rodas e a chuva atrás de dois passageiros que falam inglês natural. Lia pergunta: "Estamos quase lá?" Marco responde: “Próxima parada”. Termine com uma curta cauda de trem e sem música.
Exemplo de escrita: substitua a imagem falantes e as linhas pelas suas. Nenhum áudio foi gerado para este exemplo.
Mapeie vozes para funções
Nora@Audio1
Ethan@Audio2
Ilustração de planejamento de entrada
TA2A
Texto com referências de áudio
Escolha TA2A quando você tiver uma voz alvo ou quiser uma voz consistente para cada falante. Mapeie cada clipe para um papel e descreva as falas, a emoção e a alternância no texto.
Escolhendo clipes de referência
Prefira clipes onde a voz alvo seja clara e a interferência de fundo seja baixa. Na ordem de upload, mapeie Nora para @Audio1 e Ethan para @Audio2 e, em seguida, forneça as falas de cada um.
Ouça as referências e verifique o mapeamento de funções. Descreva as mudanças na emoção e no ritmo do prompt.
Prepare clipes de referência com no máximo 30 segundos e no máximo 10 MB cada. Use material de sua propriedade ou que tenha permissão para usar.
04 / VOICE CHECKLIST
Dê uma direção a cada falante.
VOICE DIRECTIONOuça o personagem. Em seguida, descreva a voz.
Qualidade vocalEmoçãoRitmo
✓
Função
Quem está falando e como eles se relacionam com a cena?
✓
Qualidade vocal
Escolha características úteis, como quente, brilhante, respirante ou baixo.
✓
Idioma
Nomeie o idioma e qualquer sotaque que a cena precise.
✓
Emoção
Comece com uma deixa controlada e depois ouça.
✓
Ritmo
Descreva a alternância natural, as pausas e a ênfase.
✓
Desempenho
Adicione uma respiração, ria ou sussurre apenas onde pertence.
Combine as instruções em uma frase
Um narrador adulto com uma voz calorosa e ligeiramente baixa fala um inglês natural em um ritmo moderado, com uma entrega calma, pausas fáceis entre as frases e leve ênfase nas frases-chave.
05 / LAYER TIMELINE
Coloque cada som na cena.
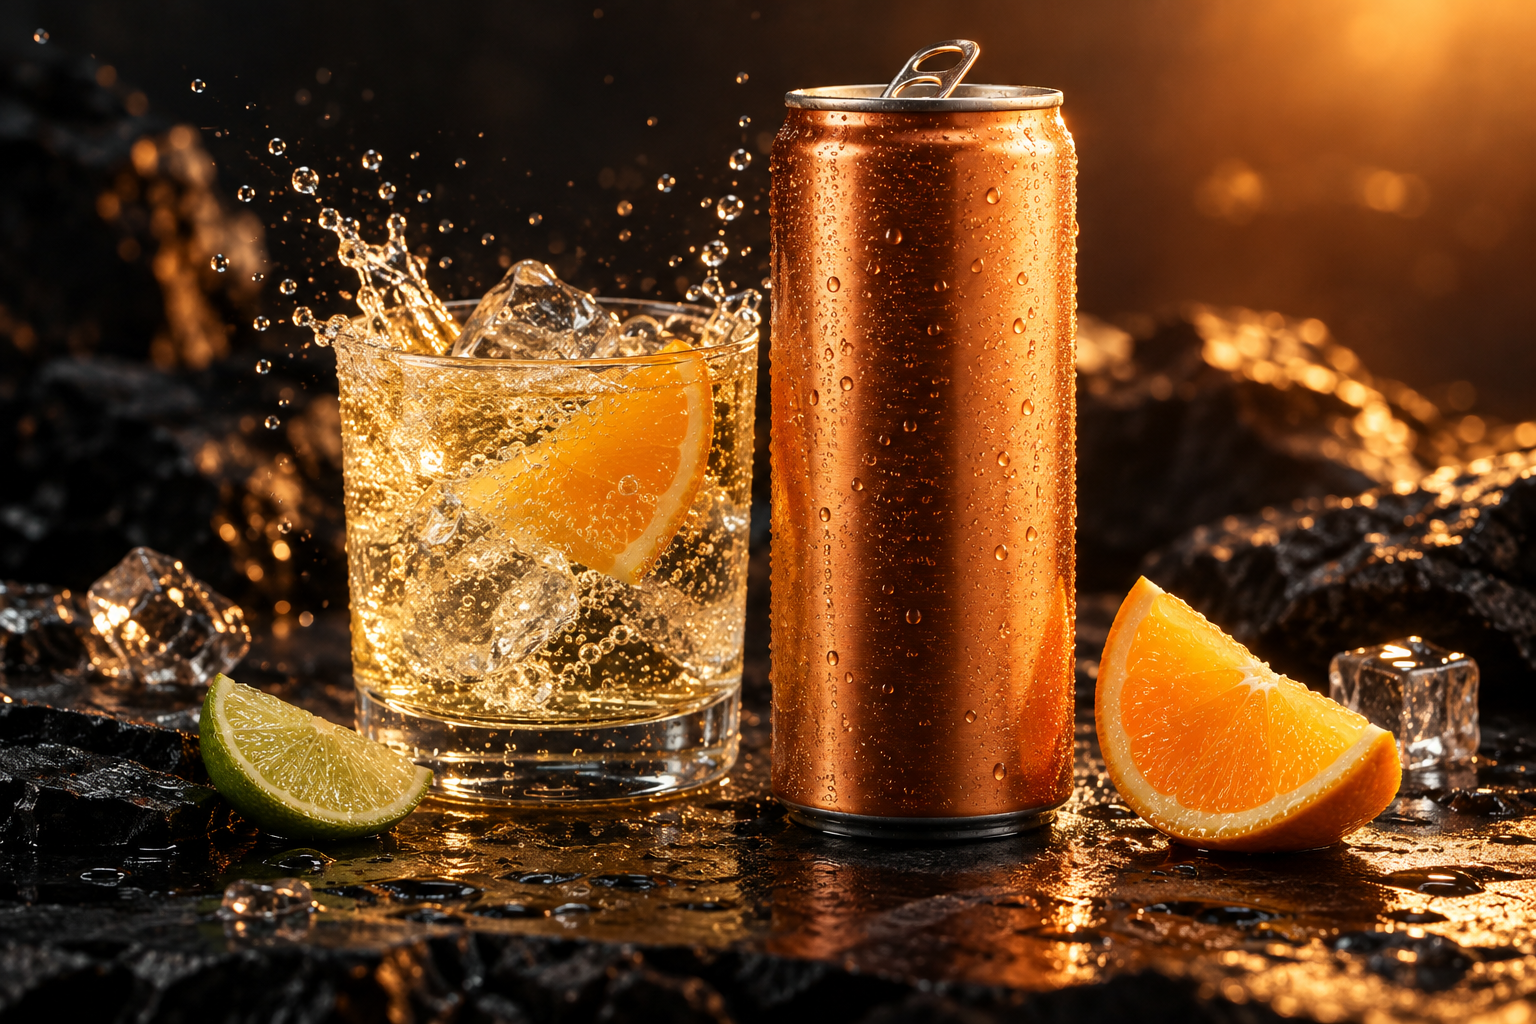
Use The First Sip para ver a ordem: a lata abre, o gelo e a efervescência estabelecem o produto, a fala chega e a música resolve. Os tempos abaixo vêm do prompt original e são alvos, não pontos de edição garantidos.
THE FIRST SIPO primeiro gole00:00 — 00:12
0–2s
Abertura
Abertura de lata, gelo e vazamento.
2–8s
Discurso
Uma linha de produtos curta e clara.
1–12s
Música por baixo
Um ritmo otimista permanece abaixo da voz.
Às 12h
Finalizando
Bolhas e música resolvem juntas.
Abertura
Discurso
Música por baixo
Diagrama de planejamento de som · o resultado é uma faixa de áudio mixada.
06 / ORIGINAL EXAMPLES
Aprenda com o prompts original.
Ouça três cenas e veja como prompts organiza diálogos, sons de produtos e referências de voz. Cada um inclui áudio, o prompt completo enviado e instruções principais que você pode adaptar à sua própria cena.
01 / T2A
O último trem
O que ouvir Compare as versões italiana e chinesa. Ouça a curva natural e onde as rodas e a chuva ficam por trás das vozes.
O Último Trem · Italiano
0:00 / 0:00
Como funcionam as principais instruções
Rodas suaves e contínuas e chuva atrás de vozes próximas e claras. Define a prioridade de escuta. Troque a chuva pelo ambiente de café, mantendo a fala na frente.
sem pausas dramáticas ou palavras prolongadas Dirige o ritmo e a tomada de turnos. Substitua isso por uma entrega mais calma ou hesitante quando a cena precisar.
Fale apenas as linhas citadas. Separa as palavras faladas das direções da cena. Substitua o diálogo entre aspas.
02 / T2A
O primeiro gole
O que ouvir Ouça os sons da lata e do gelo abrindo, quando a voz chega e como as bolhas e a música terminam.
O primeiro gole
0:00 / 0:00
Como funcionam as principais instruções
um encaixe de aba de puxar em alumínio nítido Nomeia um som de abertura distinto. Troque-o por embalagem, pressionar um botão ou outra ação chave.
fica embaixo da voz Coloca a música por trás da narração. Mude o estilo musical mantendo a fala na frente.
Deixe as bolhas e a música resolverem juntas Explica como a cena deve terminar. Substitua seu próprio som final e seu final.
03 / TA2A
Dezesseis segundos para escapar
O que ouvir Ouça primeiro Nora e Ethan e depois compare a cena gerada. Siga o mapeamento de voz e os sons de ação em torno de suas linhas.
@Audio1 · Referência de entrada
Nora
0:00 / 0:00
@Audio2 · Referência de entrada
Ethan
0:00 / 0:00
Áudio gerado
Dezesseis segundos para escapar
0:00 / 0:00
Como funcionam as principais instruções
dublado por @ Audio1 Mapeia Nora para a primeira referência; Ethan segue @ Audio2. Altere os nomes mantendo a ordem de upload consistente.
Uma alavanca faz barulho. O motor pega com um rugido crescente e poderoso. Sequencia sons de ação. Ao substituir ações, diga a que lugar cada som pertence no diálogo.
O alarme para; um zumbido suave do motor substitui o casco trêmulo Usa uma mudança de som para resolver a cena. Troque os sons de fundo e diga o que o interrompe e o que o substitui.
07 / COMMON MISTAKES
Se a mixagem parecer lotada, simplifique.
01
Muitas camadas concorrentes
Mantenha uma cama ambiente e um pequeno número de eventos que ajudem o cenário.
02
Referências não mapeadas
Diga ao modelo qual função segue cada referência @Audio.
03
Uma pilha de palavras-chave
Vago: "Chuva, trem, cinematográfico." Mais claro: "Comece com rodas e chuva, deixe dois passageiros se revezarem para falar e termine com uma curta cauda ambiente de carruagem."
04
Dicas de entrega conflitantes
Escolha uma emoção principal e um ritmo claro para cada falante.
05
Tratando a duração como exata
Ouça o resultado e deixe espaço para cortes em sua edição.
06
Nomes em vez de direção de voz
Descrever um papel e qualidades vocais; use referências de voz com permissão.
NEXT SCENE
Comece sua próxima cena com um modelo.
Copie um modelo, substitua a cena e o diálogo e cole-o no gerador. Depois de ouvir, mude um detalhe de cada vez e compare o discurso, o histórico e o final.