Utilice esta guía Seed Audio 1.0 prompt para planificar diálogos, música, ambiente y efectos de sonido. Comience con una plantilla, mapee sus referencias de voz y aprenda qué hace cada instrucción a través de ejemplos reproducibles.
Voces claras + ruedas blandas y lluvia · sin música
Un resumen del prompt original
01
Se requiere texto
El texto solo funciona. Mantenga su prompt dentro de los 2048 caracteres.
02
Las referencias son opcionales.
Si es necesario, agregue una imagen o hasta tres clips de audio. No los combine.
03
Mapear voces en orden
Para referencias de audio, utilice @Audio1, @Audio2 y @Audio3 en orden de carga.
THE SHORT VERSION
Escribe en orden de reproducción.
Describe qué sucede primero, en qué debe concentrarse el oyente y cómo termina la escena. Conserve sólo las voces y las capas de sonido que necesita la escena.
01 / TEMPLATES
Comience con un resumen claro.
Copie una plantilla y reemplace los corchetes. Elimine la música, hablantes o los efectos no utilizados y coloque las líneas habladas entre comillas. Mantenga una descripción escrita incluso cuando agregue una imagen o una referencia de audio.
T2A · Texto, imagen opcional
Cree una [duración objetivo] [formato de audio o escena] en [idioma].
Escena: [lugar, acción y estado de ánimo].
Voz: [hablante, cualidades vocales, emoción y ritmo].
Diga sólo: "[diálogo o narración exacta]".
Apertura: [primer evento audible].
Luego: [diálogo y acciones en orden de reproducción].
Ambiente: [sonidos de fondo continuos, distancia e intensidad].
Música: [estilo, instrumentos, intensidad, entrada y final; eliminar si no se utiliza].
Efectos de sonido: [sonidos de acción clave en orden; eliminar si no se utiliza].
Finalizando: [último evento y decadencia natural].
Cuando el discurso dirige, mantenga el ambiente y la música debajo.
Omitir: [voces, música o efectos no deseados].
TA2A · Referencias texto + audio
Utilice @Audio1 como referencia de voz para [hablante A].
Utilice @Audio2 como referencia de voz para [hablante B, si es necesario].
Crea una escena de [duración objetivo] en [idioma].
Escena: [lugar, acción y estado de ánimo].
hablante A ([emoción, ritmo y pausas]): "[línea exacta]".
hablante B ([entrega, si es necesario]): "[respuesta exacta]".
Ambiente: [sonidos de fondo continuos, distancia e intensidad].
Música: [estilo, instrumentos, intensidad, entrada y final; eliminar si no se utiliza].
Efectos de sonido: [apertura, acciones y final en orden].
Mantenga el ambiente y la música debajo del diálogo y cada hablante asignado a la misma referencia.
Retire el hablantes y las líneas de referencia no utilizadas. Diga sólo las líneas citadas.
02 / PROMPT FORMULA
Cuatro decisiones antes de escribir.
01
escena
Establece el formato, lugar, acción, idioma, estado de ánimo y duración del objetivo.
02
Voz
Nombra el hablante y las líneas exactas, luego describe la calidad vocal, la emoción y el ritmo.
03
Línea de tiempo
Comience con la apertura, organice el diálogo y las acciones, luego describa el final.
04
capas
Ambiente, música y efectos clave separados. Di lo que lleva y lo que queda detrás.
03 / INPUT MODES
Elige lo que guía el sonido.
Comience con el texto al inventar una escena sonora. Agregue audio cuando ya tenga una dirección de voz a la que hacer referencia. Ambos caminos aún necesitan una descripción escrita de la escena y los eventos sonoros.
Breve escrito
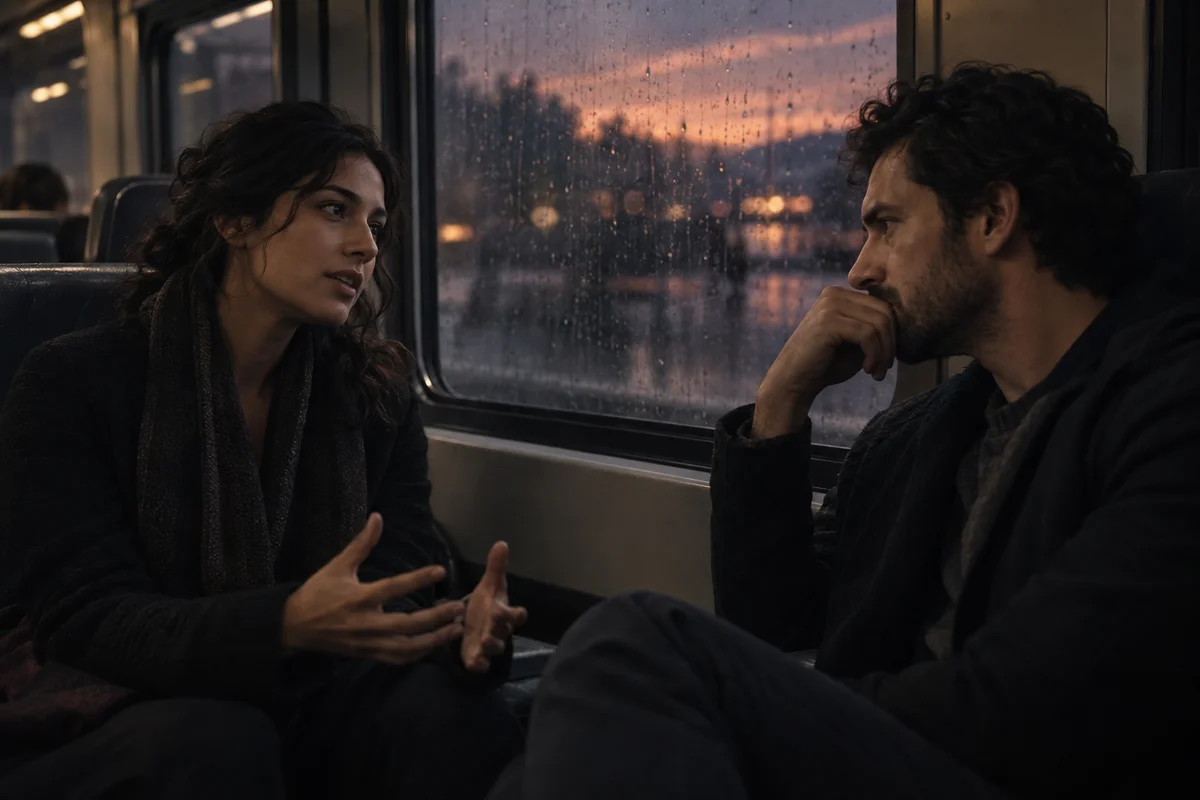
Un tren nocturno. Dos voces se turnan, con la lluvia detrás de ellas.
Opcional: una imagen de escena
Ilustración de planificación de entrada
T2A
Texto, con una imagen opcional.
Elija T2A cuando desee que el modelo diseñe el sonido a partir de su descripción. El texto por sí solo es suficiente; una imagen puede ayudar a establecer la escena. No agregue referencias de audio cuando utilice una imagen.
Ejemplo de escritura guiada por imágenes
Utilice la imagen del tren nocturno cargada como referencia de escena. Mantenga las ruedas y la lluvia detrás de dos pasajeros que hablan inglés natural. Lia pregunta: "¿Ya casi llegamos?" Marco responde: "Próxima parada". Termina con una cola de tren corta y sin música.
Ejemplo de escritura: reemplace la imagen, hablantes y las líneas por las suyas. No se ha generado ningún audio para este ejemplo.
Asignar voces a roles
Nora@Audio1
Ethan@Audio2
Ilustración de planificación de entrada
TA2A
Texto con referencias de audio.
Elija TA2A cuando tenga una voz objetivo o desee una voz consistente para cada hablante. Asigna cada clip a un rol y luego describe las líneas, las emociones y los turnos en el texto.
Elegir clips de referencia
Prefiere clips donde la voz objetivo sea clara y la interferencia de fondo sea baja. En orden de carga, asigne a Nora a @Audio1 y a Ethan a @Audio2, luego proporcione a cada uno sus líneas.
Escuche las referencias y consulte el mapeo de roles. Describe los cambios en la emoción y el ritmo en el prompt.
Prepare clips de referencia que no duren más de 30 segundos ni superen los 10 MB cada uno. Utilice material de su propiedad o que tenga permiso para utilizar.
04 / VOICE CHECKLIST
Dé una dirección a cada hablante.
VOICE DIRECTIONEscuche al personaje. Luego describe la voz.
calidad vocalemociónritmo
✓
Rol
¿Quién habla y cómo se relacionan con la escena?
✓
calidad vocal
Elija rasgos útiles como cálido, brillante, entrecortado o bajo.
✓
Idioma
Nombra el idioma y cualquier acento que necesite la escena.
✓
emoción
Comience con una señal controlada y luego escuche.
✓
ritmo
Describe los turnos naturales, las pausas y el énfasis.
✓
Rendimiento
Añade un respiro, ríe o susurra solo donde corresponde.
Combina las instrucciones en una oración.
Un narrador adulto con una voz cálida y ligeramente baja habla inglés natural a un ritmo moderado, con una expresión tranquila, pausas fáciles entre oraciones y un ligero énfasis en las frases clave.
05 / LAYER TIMELINE
Coloca cada sonido en la escena.
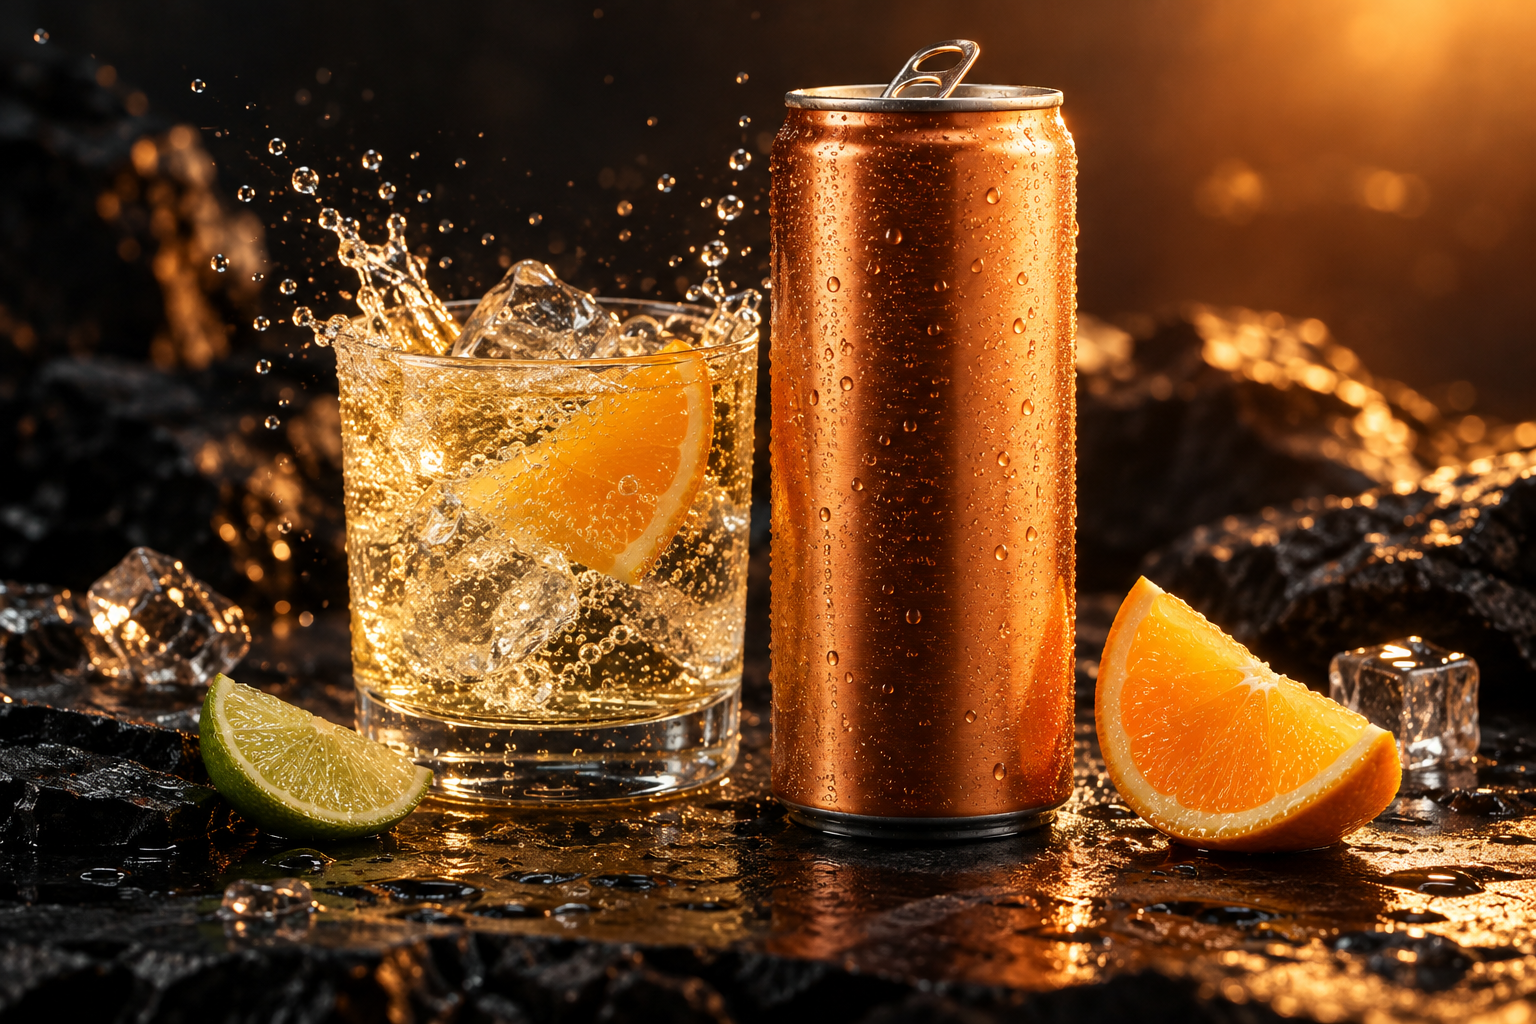
Utilice The First Sip para ver el orden: la lata se abre, el hielo y la efervescencia establecen el producto, llega el habla y luego la música se resuelve. Los tiempos a continuación provienen del prompt original y son objetivos, no puntos de edición garantizados.
THE FIRST SIPEl primer sorbo00:00 — 00:12
0-2 segundos
Apertura
Lata abriendo, hielando y vertiendo.
2–8 segundos
discurso
Una línea de productos breve y clara.
1 a 12 segundos
Música debajo
Un ritmo alegre permanece debajo de la voz.
A los 12
Finalizando
Las burbujas y la música se resuelven juntas.
Apertura
discurso
Música debajo
Diagrama de planificación de sonido · el resultado es una pista de audio mezclada.
06 / ORIGINAL EXAMPLES
Aprenda del prompts original.
Escuche tres escenas y vea cómo prompts organiza los diálogos, los sonidos de los productos y las referencias de voz. Cada uno incluye audio, el prompt completo enviado e instrucciones clave que puedes adaptar a tu propia escena.
01 / T2A
El último tren
Que escuchar Compare las versiones italiana y china. Escuche los turnos naturales y dónde las ruedas y la lluvia se encuentran detrás de las voces.
El último tren · Italiano
0:00 / 0:00
Cómo funcionan las instrucciones clave
Ruedas suaves y continuas y lluvia detrás de voces cercanas y claras. Establece la prioridad de escucha. Cambie la lluvia por el ambiente de una cafetería manteniendo la palabra al frente.
sin pausas dramáticas ni palabras interminables Dirige el ritmo y los turnos. Reemplázalo con una expresión más tranquila o más vacilante cuando la escena lo necesite.
Diga sólo las líneas citadas. Separa las palabras habladas de las direcciones de la escena. Reemplace el diálogo dentro de las comillas.
02 / T2A
El primer sorbo
Que escuchar Escuche los sonidos de la lata y el hielo al abrirse, cuando llega la voz y cómo terminan las burbujas y la música.
El primer sorbo
0:00 / 0:00
Cómo funcionan las instrucciones clave
un cierre de lengüeta de aluminio nítido Nombra un sonido de apertura distinto. Cámbielo por un embalaje, presionar un botón u otra acción clave.
permanece debajo de la voz Coloca la música detrás de la narración. Cambie el estilo musical manteniendo el habla al frente.
Deja que las burbujas y la música se resuelvan juntas. Explica cómo debe terminar la escena. Sustituye tu propio sonido final y su final.
03 / TA2A
Dieciséis segundos para escapar
Que escuchar Escuche primero a Nora y Ethan, luego compare la escena generada. Sigue el mapeo de voz y los sonidos de acción alrededor de sus líneas.
@Audio1 · Referencia de entrada
Nora
0:00 / 0:00
@Audio2 · Referencia de entrada
Ethan
0:00 / 0:00
audio generado
Dieciséis segundos para escapar
0:00 / 0:00
Cómo funcionan las instrucciones clave
expresado por @Audio1 Asigna a Nora a la primera referencia; Ethan sigue a @Audio2. Cambie los nombres manteniendo coherente el orden de carga.
Una palanca suena. El motor arranca con un rugido cada vez más potente. Secuencias de sonidos de acción. Al reemplazar acciones, diga a qué lugar del diálogo pertenece cada sonido.
La alarma se detiene; un suave zumbido del motor reemplaza el casco tembloroso Utiliza un cambio de sonido para resolver la escena. Cambie los sonidos de fondo y diga qué lo detiene y qué lo reemplaza.
07 / COMMON MISTAKES
Si la mezcla se siente abarrotada, simplifique.
01
Demasiadas capas en competencia
Mantenga una cama ambiental y una pequeña cantidad de eventos que ayuden a la escena.
02
Referencias no asignadas
Dígale al modelo qué rol sigue a cada referencia de @Audio.
03
Un montón de palabras clave
Vago: "Lluvia, tren, cinematográfico". Más claro: "Comience con las ruedas y la lluvia, deje que dos pasajeros se turnen para hablar y luego termine con una breve cola ambiental del carruaje".
04
Señales de entrega contradictorias
Elige una emoción principal y un ritmo claro para cada hablante.
05
Tratar la duración como exacta
Escuche el resultado y deje espacio para recortar en su edición.
06
Nombres en lugar de dirección de voz
Describir un rol y cualidades vocales; utilizar referencias de voz con permiso.
NEXT SCENE
Comience su próxima escena con una plantilla.
Copie una plantilla, reemplace la escena y el diálogo, luego péguelo en el generador. Después de escuchar, cambie un detalle a la vez y compare el discurso, el trasfondo y el final.